
Cuando vi el video de referencia, mi primera reacción fue: deberíamos poder imitar este video. La historia no es importante, solo tomemos uno al azar ahora, principalmente para ver el efecto. La imagen tiene, la historia tiene, la voz también podemos sintetizar, mi sensación en ese momento es... todo está listo, primero hacer uno y luego decirlo.
¿Cómo se construye el mapa de la historia?
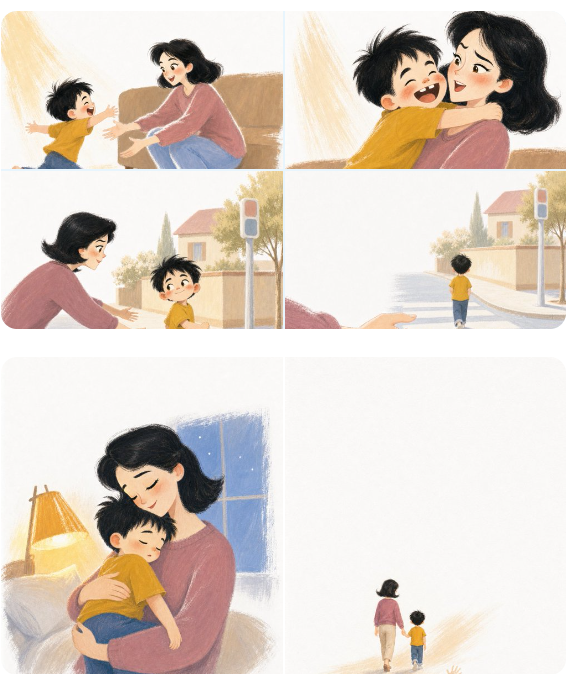
La historia es muy simple: cuando el niño era niño, siempre tenía la mano abierta para abrazarlo, y la madre se rió mientras lo abrazaba. Un día, cruzando la calle, el niño dijo por primera vez: "Yo voy solo ". La mano de mamá se detuvo en el aire, de repente no podía recordar la última vez que lo abrazó. Esa noche, ella levantó a su hijo dormido una vez más.
Lo dividimos en 6 imágenes:
-
El niño corría hacia su madre con las manos abiertas.
-
La madre lo abrió y le dijo: "Cuánto pesa ".
-
Al cruzar la calle, el niño dijo por primera vez: "Me voy yo mismo ".
-
La mano de la madre colgaba en el aire, la espalda del niño se alejaba cada vez más.
-
Por la noche, la madre recogió al niño dormido.
-
Una gran y una pequeña dos espaldas se alejan, se utilizan para contener la frase "la última vez nunca se prevé ".
Cada uno de los seis diagramas es útil. Las dos primeras imágenes convencen a la gente de que "él siempre tenía que abrazar", la tercera interrumpe la rutina, la cuarta hace que mamá reaccione, la quinta muestra sus movimientos, y la última califica para terminar. Elimina cualquiera de los medios y las emociones se volverán difíciles.
A continuación, fija la figura. Primero preparamos una imagen de referencia de la madre y una imagen de referencia del niño: la madre es negra con cabello corto a hombros, suéter púrpura de polvo de soja; el niño tiene cinco años, cabello negro desordenado, cara redonda, falta de un diente delantero, lleva una camiseta amarilla mostaza. Las seis imágenes entregan estas dos imágenes de referencia de personajes a la herramienta de generación de imágenes, y la ropa no se cambia en todo el proceso.
Y no adivines la escena solo con palabras. Salón de estar, calle y dormitorio de noche, cada uno de los preparadores de un mapa de referencia ambiental. Tome la referencia de la sala de estar cuando haga la imagen de la sala de estar, tome la referencia de la intersección cuando haga el cruce de cebra. El fondo no tiene que copiar exactamente lo mismo, pero la misma casa, la misma calle no cambiará repentinamente la decoración en diferentes imágenes.
Las imágenes utilizan la función de generación de imágenes incorporada en Codex, que hace una imagen vertical de 3: 4 por separado, sin generar texto en la imagen. El pronóstico común es más o menos el siguiente:
同一位妈妈:黑色齐肩外翘短发,鹅蛋脸尖下巴,细长脖子,
豆沙粉紫圆领毛衣。

同一个五岁男孩:头大身小,黑色乱发,圆脸短脖,
缺一颗门牙,芥末黄 T 恤。全程不换衣服。

画风:1950 年代美式中古动画概念稿,传统水粉和彩铅,
画在白纸上,大面积留白,环境像舞台布景,不像照片。

构图:3:4 竖版,顶部至少 35% 留白,四个角保持白色,
不要日系动漫脸、3D、矢量插画、满构图、文字、水印、
额外人物和服装变化。
Luego, cada imagen complementa solo con el movimiento y el entorno que realmente se necesita. Por ejemplo, el cuarto:
同一街口。妈妈豆沙粉紫袖口和悬空的手占前景,
手指微微收拢;远处是儿子穿芥末黄 T 恤走远的小背影。
画面保留大片空白,色调比上一幕稍冷,情绪克制。
No es necesario escribir mucha literatura, primero fije las cosas que cambiarán: la misma persona, la misma ropa, el mismo estilo de pintura, el mismo tipo de espacio en blanco. Una escena solo hace una imagen, tampoco tome una imagen para dos tramas.
Haga fotos desde cero y obtenga al menos 6 ilustraciones calificadas. La cantidad de veces que se generará realmente depende de si el personaje ha cambiado su cara, si las manos están rotas y si la composición puede dejar espacio para el texto. La documentación de producción en ese momento solo dejó 6 imágenes de la adopción final, sin guardar en su totalidad cada reintento y deducción, por lo que no compongo un "cuánto gastó en total".
Después de hacer seis imágenes, la práctica del cortometraje original también es muy simple: cada imagen de 4.25 segundos, primero en el papel blanco escribe chino palabra por palabra, luego deje que la versión en escala de grises de la misma imagen aparezca de izquierda a derecha, y finalmente deje que la imagen en color se cubra de izquierda a derecha. Cambiar directamente entre escenas, no dejar que los personajes se muevan. Las seis imágenes juntas son 25.5 segundos, con música de fondo y sonido de mecanografía, sin narración.
Aquí, el cortometraje de historia estática original está terminado.
Método de clasificación de video
Primero, analice el siguiente video: el diseño de cada juego es básicamente el mismo: una oración en la parte superior, una imagen en el medio, chino y inglés debajo; la voz solo lee inglés. La imagen se cambia de blanco a grises y luego se desliza de izquierda a derecha a color.
Parece que la imagen se generó en el sitio, en realidad no se utilizó un modelo de video. Copie dos capas de la misma imagen, elimine el color en la capa inferior, mantenga la imagen en color en la capa superior, y máscara de izquierda a derecha para cada una de las dos capas, es decir, suelte gradualmente el área visible. Las herramientas que usé también se explican:
-
El navegador Chrome se utiliza para ver X original y videos de referencia.
-
El propio say de macOS lee el texto inglés en voz alta.
-
Remoción es una herramienta para componer y generar videos con código web (React), responsable de las imágenes, texto, máscaras y líneas de tiempo.
-
FFmpeg es una herramienta de línea de comandos para procesar video y audio, que se encarga de la conversión de formato de audio y, finalmente, la mezcla de música de fondo; su propia ffprobe se utiliza para verificar la resolución, la velocidad de fotogramas, la duración y las pistas de audio.
-
MLX Whisper es un modelo de reconocimiento de voz nativo. Después de que la hoja esté hecha, deje que vuelva a dictar el inglés y verifique si hay palabras omitidas o truncadas.
El entorno para ejecutar el script es Node.js 22.22.1, y la parte de video utiliza Remotion 4.0.484 y FFmpeg 8.1.2. El nombre de la herramienta parece ser más, de hecho, la imagen es Remote, el sonido es FFmpeg, y otras herramientas son principalmente responsables de verificar.
Los parámetros de animación de cada escena se determinan finalmente: primero vacío 0,2 segundos, la escala de grises en 1,45 segundos para terminar de escanear, la imagen de color en 1,2 segundos para escanear. Los bordes de la máscara dejan un 10% de suavizado, y la imagen se ampliará lentamente de 1x a 1.022x. La amplitud es pequeña, pero si está quieta, 6 segundos de ver realmente como PPT.
Tiposcript
const sketchProgress = interpolate(t, [0.2, 1.65], [0, 1]);
const colorProgress = interpolate(t, [1.65, 2.85], [0, 1]);

show(grayscale(image), leftToRightMask(sketchProgress));
show(image, leftToRightMask(colorProgress));
Las capas de escala de grises y de color deben usar la misma imagen, la misma posición de recorte y el mismo valor de escala. No vuelva a crear una "imagen más parecida a un borrador de línea" para ponerlo debajo. Mientras que las dos imágenes son un poco más pobres, la cara saltará cuando la imagen en color se escanee, que es particularmente obvio.
He hecho una lista de escenas separadas. Cada campo solo registra el nombre de la imagen, el título chino, el texto chino, la transmisión oral en inglés y la posición de desplazamiento hacia arriba y hacia abajo de la imagen:
json
{
  "image": "03-i-walk.png",
  "title": "后来,他说我自己走",
  "chinese": "那天过马路,他第一次说:「我自己走。」",
  "english": "Then one day, at the crosswalk, he said it for the first time. I can walk by myself.",
  "imagePosition": "center 64%"
}
Por último, omita este parámetro de posición. Cada figura de la imagen se encuentra en una posición diferente, y se coloca mecánicamente en el centro, ya sea cortando la cabeza o cortando la mano.
Cómo conectar el sonido y los subtítulos en inglés
La transmisión oral en inglés comienza con la voz de Samantha de macOS. La velocidad de la voz es de 165 palabras en inglés por minuto, y cada sesión genera un segmento por separado. Este proceso se llama texto a voz, también a menudo abreviado como TTS.
Si la configuración de la máquina es alta, con CosyVoice Los modelos pequeños sintetizan el habla mejor.
bash
say -v Samantha -r 165 -o scene.aiff "English narration here"
ffmpeg -i scene.aiff -ar 48000 -ac 1 scene.wav
No lea seis juegos a la vez en un gran archivo. Si hay un problema con la pronunciación de la tercera escena, solo cambiará la tercera escena, y las dos primeras no tendrán que seguirlo de nuevo.
Después de que se genera el habla, la duración real de cada segmento se lee. Tome el mayor de "al menos 6,4 segundos" y "duración de la narración más 0,55 segundos" en cada escena. El corto se detiene durante al menos 6,4 segundos, y el largo se detiene durante medio segundo más. No adivines la duración de la duración de acuerdo con cuántas letras hay en inglés.
Los subtítulos en inglés no tienen un tiempo palabra por palabra. Utilizé el tiempo que se ha reproducido ÷ la duración total de este discurso para calcular cuántas palabras debían revelarse ahora. Cada párrafo tiene solo 18 - 20 palabras, lo que es suficiente para hacer este tipo de subtítulos de historias. Si desea enseñar inglés en serio, requiere que la voz se refiera a qué palabra pronunciar exactamente, entonces aún debe marcar la hora de cada palabra.
Sólo se muestra en chino, no se lee en voz alta. Los 39.6 segundos se arrastrarán rápidamente a un minuto, y la audiencia se molestará esperando.
La imagen y la voz son una versión, y la música de fondo se mezcla finalmente. El volumen de la música se establece primero en 0.08, la voz humana se reduce automáticamente cuando aparece la música, y finalmente se limita el pico de volumen máximo para evitar un estallido repentino. Los parámetros específicos originales son umbral 0.02, relación 9, ataque 18 ms, liberación 300 ms, el valor pico no es más de 0.95. Sólo son adecuados para esta película y esta música. Una canción diferente tiene que ser escuchada de nuevo. No lo considere una receta ancestral.
También hay un lugar fácil de sentirse bien consigo mismo: Whisper puede dictarse en su totalidad, lo que solo puede indicar que la máquina entiende, no representa la naturaleza del sonido. Samantha no tiene ningún problema con el método de verificación de esta versión, todavía tiene que usar el teléfono móvil para escucharlo completamente antes de enviarlo. Cansado o no, como la estación de periódico, el oído humano decide.
Resumen
En primer lugar, las figuras de referencia de los personajes son separadas. Escribe "la misma madre" cien veces en la palabra de referencia, generalmente es mejor llevar la misma figura de referencia cada vez.
En segundo lugar, una imagen por juego. No tome una foto y diga "el niño se niega a abrazarlo " y" mamá lo abraza de nuevo por la noche ", ya que la audiencia no sabrá qué ver.
En tercer lugar, la imagen de color en escala de grises no es un manuscrito de línea real. El fondo original es demasiado complicado y sigue siendo sucio después de quitar el color. Cambiar la imagen original un poco más limpia es útil que tirar el contraste loco.
Cuarto, no deje que el modelo de video vuelva a hacer toda la película una vez. Esta forma requiere la estabilidad de los personajes, la composición y el texto, pero no tiene que confiar en el movimiento continuo para explicar el contenido. El modelo de video cambia la cara, la mano o la ropa por una y reelabora más.
Quinto, la música de fondo se agrega al final. No te apresures a hacer música antes de que la imagen y la transmisión oral no se fijen, de lo contrario, no sabes si la historia es lenta, la voz es lenta o la música está robando la voz.
En sexto lugar, solo reconoce el MP4 final. Volví a entregar la película al reconocimiento de voz local, todos los seis pasajes en inglés, y comprobé automáticamente el lienzo, la velocidad de fotogramas, la codificación y la pista de audio. La vista previa en el editor es normal, lo que no significa que el archivo exportado debe ser normal.
Esta vez no voy a convertirlo en una nueva línea de ensamblaje. Tomé esta película para verificar solo una cosa: ya tengo un conjunto de ilustraciones de historias con personajes estables y composiciones limpias en la mano. Cambiando un diseño y una línea de tiempo, puedo hacer este efecto de dibujo a mano bilingüe.
Primero cambiaré una voz en inglés más natural (CosyVoice), lo enviaré para ver los datos y luego decidiré si vale la pena hacer más.