
Quand j'ai vu la vidéo de référence, ma première réaction a été : nous devrions être en mesure de copier cette vidéo. L'histoire n'est pas importante, prenez-nous maintenant n'importe qui, regardez principalement l'effet. Avec l'image, l'histoire, la voix, nous pouvons également synthétiser, mon sentiment à ce moment-là est... tout est prêt, faites-en un avant de dire.
Comment les storyboards sont-ils faits ?
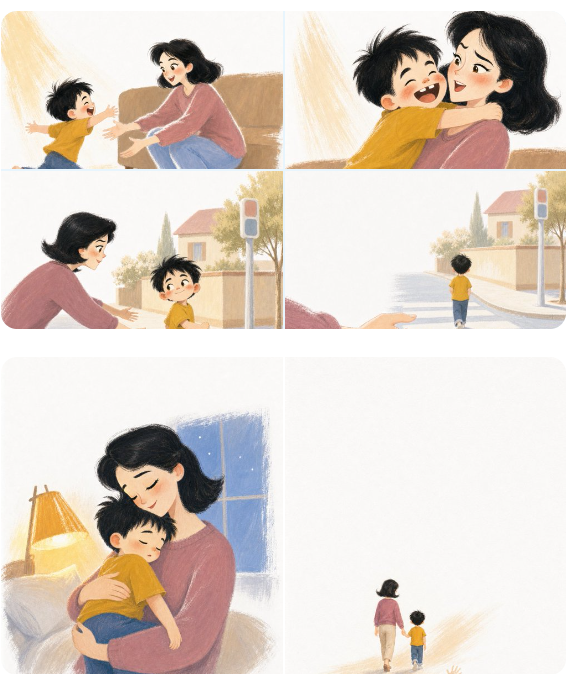
L'histoire est simple : quand l'enfant était enfant, il avait toujours les mains ouvertes pour le tenir, et sa mère riait de lui tout en le tenant. Puis un jour, en traversant la rue, l'enfant dit pour la première fois : « Je vais aller seul ». La main de sa mère s'arrêta dans l'air, soudain ne se souvenait pas de la dernière fois que je l'avais抱é. Cette nuit-là, elle a soulevé son enfant endormi une fois de plus.
Nous l'avons divisé en 6 images :
-
L'enfant ouvrit les mains et courut vers sa mère.
-
Ma mère l'a pris et lui a dit : « Il pèse beaucoup ».
-
En traversant la rue, l'enfant dit pour la première fois : « Je vais marcher seul ».
-
La main de la mère était suspendue dans l'air, le dos de l'enfant s'éloignait de plus en plus.
-
Dans la nuit, la mère a repris son enfant endormi.
-
Un grand un petit deux dos loin, utilisé pour contenir la phrase "dernière fois, jamais préavis".
Chacune des six images a des avantages. Les deux premiers font croire que « il avait l'habitude d'avoir des bras », le troisième interrompt la routine quotidienne, le quatrième fait réagir la mère, le cinquième donne ses mouvements, et le dernier est qualifié pour la fin.Éliminez l'un des deux, et l'émotion deviendra difficile à agiter.
Ensuite, fixez le personnage. Nous avons d'abord préparé une image de référence de la mère et une image de référence de l'enfant : la mère est noire avec des cheveux courts allant jusqu'à l'épaule, un pull violet en poudre de soja ; l'enfant a cinq ans, des cheveux noirs désordonnés, un visage rond, manquant d'une dent de devant, portant un t-shirt jaune moutarde. Les six images ont donné les deux images de référence de personnages à l'outil de génération d'images, et les vêtements ne sont pas changés tout au long du processus.
Ne devinez pas seulement les mots. Le salon, l'entrée et la chambre de nuit, chacun préparer un plan de référence environnemental. Prenez la référence du salon lorsque vous faites l'image du salon, et prenez la référence de l'intersection de rue lorsque vous faites la traversée des zèbres. L'arrière-plan n'a pas besoin de copier exactement le même, mais la même maison et la même rue ne changent pas soudainement de décoration dans des images différentes.
Les images utilisent la fonction de génération d'images intégrée de Codex, une seule image verticale, 3 : 4, ne génère pas de texte dans l'image. La suggestion commune est à peu près la suivante :
同一位妈妈:黑色齐肩外翘短发,鹅蛋脸尖下巴,细长脖子,
豆沙粉紫圆领毛衣。

同一个五岁男孩:头大身小,黑色乱发,圆脸短脖,
缺一颗门牙,芥末黄 T 恤。全程不换衣服。

画风:1950 年代美式中古动画概念稿,传统水粉和彩铅,
画在白纸上,大面积留白,环境像舞台布景,不像照片。

构图:3:4 竖版,顶部至少 35% 留白,四个角保持白色,
不要日系动漫脸、3D、矢量插画、满构图、文字、水印、
额外人物和服装变化。
Ensuite, chaque image ne complète que l'action et l'environnement qui sont vraiment nécessaires. Par exemple, le 4ème :
同一街口。妈妈豆沙粉紫袖口和悬空的手占前景,
手指微微收拢;远处是儿子穿芥末黄 T 恤走远的小背影。
画面保留大片空白,色调比上一幕稍冷,情绪克制。
Il n'est pas nécessaire d'écrire beaucoup de littérature, d'abord fixer les choses qui changent : la même personne, le même vêtement, le même style de peinture, la même catégorie de blanc. Une scène ne fait qu 'une image, ne prenez pas non plus une image pour le haut dur de deux intrigues.
Faites-le à partir de zéro et obtenez un minimum de 6 illustrations qualifiées. Le nombre de fois qu 'il est réellement généré dépend de si le personnage a changé de visage, si la main est mauvaise et si la composition peut laisser de la place du texte. La documentation de production à l'époque ne laissait que les 6 images de l'adoption finale, sans enregistrement complet pour chaque réessai et déduction, donc je n'ai pas compilé un "combien coûte au total".
Après que les six images soient faites, la pratique du court-métrage original est également très simple : chaque image est de 4,25 secondes, d'abord taper le chinois mot à mot sur le papier blanc, puis laisser la version en niveaux de gris de la même image apparaître de gauche à droite, et enfin laisser la carte couleur couvrir de gauche à droite. Basculer directement entre les scènes sans laisser les personnages bouger. Les six images sont combinées pour 25,5 secondes, avec de la musique de fond et du son de frappe, sans narration.
Ici, le court-métrage d'histoire statique original n'est pas terminé.
Méthode d'arrangement vidéo
Tout d'abord, analysez la vidéo suivante : la mise en page de chaque scène est fondamentalement inchangée : une phrase en haut, une image au milieu, en bas en chinois et en anglais ; la voix ne lit que l'anglais. L'image passe d'abord de blanc à gris, puis balaie de gauche à droite en couleur.
On dirait que les images sont générées sur le terrain, en fait, pas de modèle vidéo. La même image copie deux couches, la couche inférieure supprime la couleur, la couche supérieure conserve la couleur, et les deux couches sont masquées de gauche à droite, c'est - à - dire que la zone visible est progressivement libérée. Les outils que j'ai utilisés sont également expliqués :
-
Le navigateur Chrome est utilisé pour afficher les publications originales X et les vidéos de référence.
-
La fonction say intégrée à macOS lit le texte anglais en voix.
-
Remotion est un outil pour la typographie et la génération de vidéos avec le code web (React), en charge des images, du texte, des masques et de la chronologie.
-
FFmpeg est un outil de ligne de commande pour le traitement de la vidéo et de l'audio, responsable de la conversion du format audio et du mélange final de la musique de fond ; il est livré avec ffprobe pour vérifier la résolution, la fréquence d'images, la durée et les pistes.
-
MLX Whisper est un modèle de reconnaissance vocale native. Après avoir fait le film, laissez-le dicter à nouveau l'anglais et vérifiez s'il y a des mots manquants ou tronqués.
L'environnement d'exécution du script est Node.js 22.22.1, et la partie vidéo utilise Remotion 4.0.484 et FFmpeg 8.1.2. Le nom de l'outil semble beaucoup, en fait, l'image appartient à Remotion, le son appartient à FFmpeg, et d'autres outils sont principalement responsables de la vérification.
Les paramètres d'animation de chaque scène sont finalement définis comme suit : 0,2 seconde vide, 1,45 seconde pour balayer le graphique en niveaux de gris, et 1,2 seconde pour balayer le graphique en couleur. Laisser 10% de ramollissement sur les bords du masque et agrandir lentement l'image de 1x à 1.022x. L'amplitude est petite, mais si elle est immobile, 6 secondes de regarder ressemble vraiment à un ppt.
Typescript
const sketchProgress = interpolate(t, [0.2, 1.65], [0, 1]);
const colorProgress = interpolate(t, [1.65, 2.85], [0, 1]);

show(grayscale(image), leftToRightMask(sketchProgress));
show(image, leftToRightMask(colorProgress));
La couche de gris et la couche de couleur doivent utiliser la même image, la même position de découpe et la même valeur de mise à l'échelle. Ne créez pas une autre image « plus comme un brouillon de ligne » et mettez-la ci-dessous. Tant que les cinq sens sont un peu différents des deux images, le visage sautera lorsque la carte de couleur est balayée, ce qui est particulièrement évident.
J'ai fait une autre liste de scènes. Chaque enregistrement du nom de l'image, du titre chinois, du texte chinois, de la diffusion orale anglaise et de la position du décalage de haut en bas de l'image :
Json
{
  "image": "03-i-walk.png",
  "title": "后来,他说我自己走",
  "chinese": "那天过马路,他第一次说:「我自己走。」",
  "english": "Then one day, at the crosswalk, he said it for the first time. I can walk by myself.",
  "imagePosition": "center 64%"
}
Enfin, le paramètre de position est omis. Chaque personnage de la figure est positionné différemment, tous mécaniquement placés au centre, soit couper la tête, soit couper les mains.
Comment connecter la voix et les sous-titres en anglais
La diffusion orale anglaise utilise d'abord la voix de Samantha fournie par macOS. La vitesse de la parole est de 165 mots anglais par minute, et chaque session génère un segment séparé. Ce processus s'appelle Word-to - Speech, également abrégé en TTS.
Si la configuration de la machine est élevée, avec Cosyvoice Les petits modèles synthétisent la parole mieux
Bash
say -v Samantha -r 165 -o scene.aiff "English narration here"
ffmpeg -i scene.aiff -ar 48000 -ac 1 scene.wav
Ne lisez pas six matchs à la fois en un gros fichier. Il y a un problème de prononciation dans le troisième jeu, alors il suffit de changer le troisième jeu, et les deux premiers ne doivent pas être suivis à nouveau.
Une fois la parole générée, la durée réelle de chaque segment est lue. Prenez la valeur la plus élevée de "au moins 6,4 secondes" et "durée de la narration plus 0,55 secondes" pour chaque scène. Arrêtez-vous pendant au moins 6,4 secondes pour le court, et laissez une demi-seconde de plus pour le long. Ne devinez pas la durée en fonction du nombre de lettres en anglais, non.
Les sous-titres anglais n'ont pas de code de temps mot par mot. J'ai utilisé le temps écoulé ÷ la durée totale de la parole pour calculer le nombre de mots à montrer maintenant. Chaque paragraphe ne contient que 18 - 20 mots, ce qui suffit pour faire ce type de sous-titres d'histoire. Si vous voulez enseigner l'anglais sérieusement, vous devez toujours marquer le temps pour chaque mot.
Le chinois est affiché uniquement, pas lu à haute voix. Le chinois et l'anglais seront lus à 39,6 secondes, et le public attendra très ennuyeusement.
L'image et la voix sont une version, et la musique de fond est finalement mélangée. Le volume de la musique est d'abord placé à 0,08, lorsque la voix apparaît, la musique est automatiquement abaissée, et enfin la valeur maximale du volume est limitée pour éviter les explosions soudaines. Les paramètres spécifiques d'origine sont le seuil 0,02, le rapport 9, l'attaque 18 ms, la libération 300 ms, la valeur maximale ne dépasse pas 0,95. Ils ne fonctionnent que pour ce film et cette musique. Vous devez écouter à nouveau une chanson différente. Ne le prenez pas comme une recette ancestrale.
Il y a aussi un endroit où il est facile de se sentir bien : Whisper peut être dicté dans son intégralité, ce qui ne peut que dire que la machine comprend et ne représente pas la nature du son. Il n'y a aucun problème pour Samantha de vérifier cette version. Avant de l'envoyer, je dois encore écouter complètement avec mon téléphone portable. Fatigué ou non, comme la station, l'oreille humaine décide.
Résumé
Tout d'abord, les figures de référence sont omis.Écrivez « la même mère » cent fois dans le mot d'invite, il est généralement préférable d'apporter la même image de référence à chaque fois.
Deuxièmement, une image par jeu. Ne prenez pas une photo et dites « l'enfant refuse de l'embrasser » et « la mère l'embrasse à nouveau la nuit », le public ne saurait quelle phrase regarder.
Troisièmement, le graphique en couleur en niveaux de gris n'est pas un réel manuscrit de ligne. L'arrière-plan de l'image originale est trop compliqué, et il est toujours sale après avoir enlevé la couleur. Changer l'image originale un peu plus propre, plus utile que de tirer le contraste fou.
Quatrièmement, ne laissez pas le modèle vidéo refaire l'ensemble du film une fois. Cette forme nécessite la stabilité des personnages, de la composition et du texte, mais il n'y a pas de contenu qui doit être expliqué clairement par des mouvements continus. Le modèle vidéo change un visage, une main ou un vêtement, et retravaille plus.
Cinquièmement, la musique de fond est ajoutée en dernier. Ne vous précipitez pas avec de la musique avant que l'image et la diffusion orale ne soient pas fixées, sinon vous ne savez pas si l'histoire est lente, la voix est lente ou la musique est en train de voler la voix.
Sixièmement, seul le MP4 final est reconnu. J'ai remis le film à la reconnaissance vocale locale, les six paragraphes en anglais, et j'ai automatiquement vérifié la toile, la fréquence d'images, le codage et la piste. L'aperçu dans l'éditeur est normal, ce qui ne signifie pas que le fichier exporté doit être normal.
Je ne vais pas en faire une nouvelle ligne de montage cette fois-ci. Je prends cette feuille pour vérifier seulement une chose : j'ai déjà un ensemble d'illustrations d'histoires avec des personnages stables et une composition propre dans ma main. En changeant la mise en page et la chronologie, je peux faire cet effet de peinture à la main bilingue.
Je vais d'abord changer pour une voix anglaise plus naturelle (CosyVoice), l'envoyer pour jeter un coup d'œil aux données, puis décider si cela vaut la peine de faire plus.