
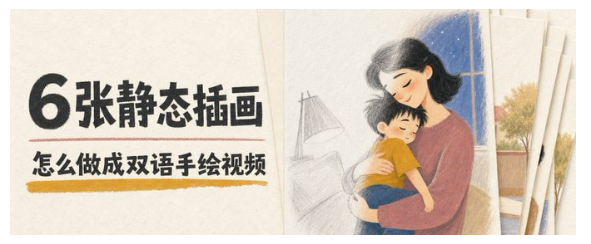
Als ich das Video sah, war meine erste Reaktion: Wir sollten dieses Video kopieren können. Die Geschichte ist nicht wichtig, nehmen wir jetzt eine zufällige, hauptsächlich schauen wir auf die Wirkung.图有了,故事有了,语音我们也能合成,我当时的感觉就是……万事俱备了,先做一个出来再说。
Wie ist die Story gemacht.
Die Geschichte ist sehr einfach: Das Kind als Kind hat immer die Hände geöffnet, um ihn zu umarmen, und die Mutter hat ihn während der Umarmung lacht. Eines Tages überquerte das Kind die Straße und sagte zum ersten Mal: „Ich gehe selbst". Die Hände seiner Mutter blieben leer und er konnte sich plötzlich nicht erinnern, wann sie ihn das letzte Mal umarmt hatte. Am Abend nahm sie das schlafende Kind wieder auf.
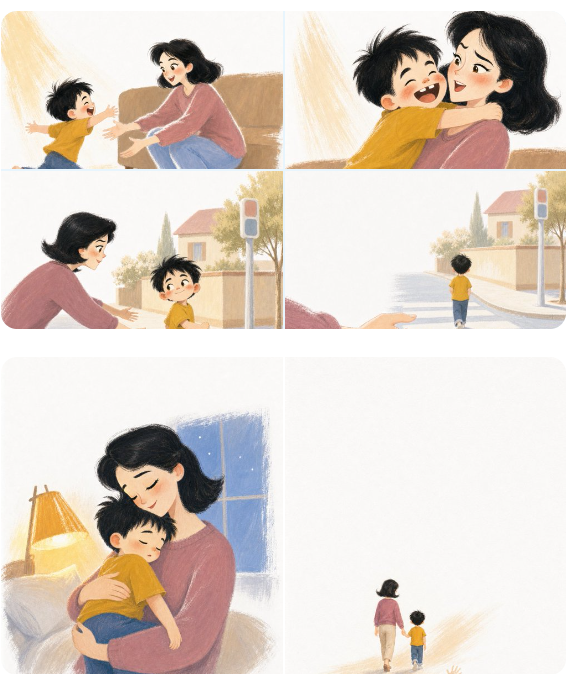
Wir haben es in sechs Bilder aufgeteilt:
-
Das Kind öffnete die Hände und rannte zur Mutter.
-
Seine Mutter hob ihn auf und sagte: „Es ist wie schwer."
-
Beim Überqueren der Straße sagt das Kind zum ersten Mal: „Ich gehe selbst".
-
Die Hände der Mutter hängen in der Luft, und der Rücken des Kindes wird immer weiter.
-
Am Abend nahm die Mutter das schlafende Kind wieder auf.
-
Ein großer und ein kleiner zwei Rücken weit weg, verwendet, um zu halten "letztes Mal nie vorhergesagt" Satz.
Alle 6 Karten sind nützlich. Die ersten beiden lassen die Leute glauben, dass er früher immer umarmt hatte, das dritte unterbricht den Alltag, das vierte lässt die Mutter reagieren, das fünfte gibt ihre Bewegungen, und das letzte ist nur für das Ende qualifiziert. Wenn man irgendwelche in der Mitte wegnimmt, wird die Stimmung hart.
Und dann die feste Person. Wir haben zuerst eine Mutter Referenzbild und ein Kind Referenzbild vorbereitet: Mutter ist schwarz Schulter-aufwärts kurze Haare, Soja-Pulver violet Pullover; Kind fünf Jahre alt, schwarze Haare, rundes Gesicht, fehlt ein Vorderzähne, tragen senfgelbe T-Shirt. Die 6 Bilder geben diese beiden Referenzbilder zusammen an das Bildzeugerzeugungswerkzeug, und die Kleidung wird nicht geändert.
Die Szene sollte nicht nur aus dem Text erraten werden. Wohnzimmer, Straßenübergang und Nachtzimmer, bereiten Sie jeweils eine Referenzkarte für die Umwelt. Wenn Sie das Wohnzimmerbild machen, nehmen Sie die Wohnzimmerreferenz, wenn Sie die Zebraüberschreitung mit der Straße Referenz. Der Hintergrund muss nicht genau identisch kopiert werden, aber das gleiche Haus, die gleiche Straße in verschiedenen Bildern nicht plötzlich renoviert werden.
Bilder verwenden die eingebaute Bildgenerierungsfunktion des Codex, die ein separates Bild, 3: 4 vertikal, ohne Text in den Bildern zu erzeugen. Das gemeinsame Wort lautet ungefähr so:
同一位妈妈:黑色齐肩外翘短发,鹅蛋脸尖下巴,细长脖子,
豆沙粉紫圆领毛衣。

同一个五岁男孩:头大身小,黑色乱发,圆脸短脖,
缺一颗门牙,芥末黄 T 恤。全程不换衣服。

画风:1950 年代美式中古动画概念稿,传统水粉和彩铅,
画在白纸上,大面积留白,环境像舞台布景,不像照片。

构图:3:4 竖版,顶部至少 35% 留白,四个角保持白色,
不要日系动漫脸、3D、矢量插画、满构图、文字、水印、
额外人物和服装变化。
Jedes Bild ergänzt dann nur die wirklich benötigte Bewegung und Umgebung. Zum Beispiel die 4.:
同一街口。妈妈豆沙粉紫袖口和悬空的手占前景,
手指微微收拢;远处是儿子穿芥末黄 T 恤走远的小背影。
画面保留大片空白,色调比上一幕稍冷,情绪克制。
Schreiben Sie nicht viel Literatur, zuerst fixieren Sie die Dinge, die sich ändern: die gleiche Person, dasselbe Kleidung, die gleiche Art von Malerei, die gleiche Art von Weiß. Machen Sie nur eine Szene und nehmen Sie nicht eine Karte auf zwei Stücke.
Um die Bilder abzubilden, müssen Sie mindestens 6 qualifizierte Bilder erhalten. Wie oft tatsächlich erzeugt wird, hängt davon ab, ob die Charaktere ihr Gesicht verändert haben, ob die Hände beschädigt sind oder ob die Komposition einen Textplatz hinterlassen kann. Die Produktionsdateien zu dieser Zeit blieben nur 6 Bilder für die endgültige Annahme, ohne die vollständige Speicherung jedes Wiederversuchs und Abzüge, so dass ich nicht ein "wie viel es insgesamt ausgegeben hat" zusammengestellt.
Nach 6 Bildern ist die Praxis des ursprünglichen Kurzfilms auch sehr einfach: Jedes Bild 4,25 Sekunden, zunächst wörtlich auf weißem Papier in Chinesisch, dann lassen Sie die Graustufenversion des gleichen Bildes von links nach rechts erscheinen, schließlich lassen Sie die Farbkarte von links nach rechts abdecken. Wechseln Sie zwischen den Szenen, ohne dass sich die Personen bewegen. Die 6 Bilder zusammen sind 25,5 Sekunden, mit Hintergrundmusik und Tipping, ohne Narrator.
Hier ist die ursprüngliche Kurzgeschichte fertig.
Video-Ausschließung.
Zuerst analysieren Sie das folgende Video: Jedes Layout ist im Grunde unverändert: ein Satz oben, ein Bild in der Mitte, unten in Chinesisch und Englisch; Stimme liest nur Englisch. Das Bild wird zunächst von Leer in Graustufen verwandelt und dann von links nach rechts in Farbe gespalten.
Es sieht so aus, als ob die Bilder vor Ort erzeugt wurden, in Wirklichkeit ohne Video-Modell. Das gleiche Bild kopiert zwei Schichten, die unteren Schichten entfernen die Farbe, die oberen Schichten behalten das Farbbild, und die beiden Schichten machen jeweils einmal von links nach rechts Maske, das heißt, allmählich loslassen der sichtbaren Bereich. Ich erklärte auch die Werkzeuge, die ich benutze:
-
Der Chrome-Browser wird verwendet, um X-Beiträge und Referenzvideos anzuzeigen.
-
Das mit macOS ausgestattete say liest englische Wörter als Sprache.
-
Remotion ist ein Tool zum Typografieren und Erzeugen von Videos mit Web-Code (React), das für Bilder, Text, Masken und Timeline verantwortlich ist.
-
FFmpeg ist ein Befehlszeilen-Tool für die Verarbeitung von Video und Audio, verantwortlich für die Audio-Format - Konvertierung und schließlich für das Mixing von Hintergrundmusik; es enthält eine eigene ffprobe, die Auflösung, Framerate, Dauer und Audio-Tracks überprüft.
-
MLX Whisper ist ein Modell für lokale Spracherkennung. Nachdem das Stück fertig ist, lassen Sie es wieder auf Englisch diktieren, überprüfen Sie, ob es fehlende Wörter oder abgeschnitten.
Die Umgebung für die Ausführung des Skripts ist Node.js 22.22.1, für die Videos verwendet man Remotion 4.0.484 und FFmpeg 8.1.2. Der Name des Tools sieht viele aus, in der Tat ist das Bild Remote, der Sound FFmpeg, andere Tools sind hauptsächlich für die Überprüfung verantwortlich.
Die Animationsparameter für jede Szene werden endgültig festgelegt: zuerst 0,2 Sekunden leer, Graustufen-Grafik in 1,45 Sekunden abgescanzt, Farb-Grafik in 1,2 Sekunden gescanzt. Die Kanten der Maske lassen 10% weicher und das Bild vergrößert langsam von 1 - fach auf 1,022 - fach. Die Abweichung ist klein, aber wenn sie sich nicht bewegt, sieht 6 Sekunden wirklich wie ein PPT aus.
Typescript
const sketchProgress = interpolate(t, [0.2, 1.65], [0, 1]);
const colorProgress = interpolate(t, [1.65, 2.85], [0, 1]);

show(grayscale(image), leftToRightMask(sketchProgress));
show(image, leftToRightMask(colorProgress));
Graustufen und Farbe müssen die gleiche Abbildung, die gleiche Zerschnittsposition, den gleichen Skalierungswert verwenden. Erstellen Sie nicht mehr eine "Line-Draft - ähnliche" Grafik unten. Zwei Bilder, solange die fünf Sinne ein wenig knapp sind, wird das Gesicht springen, wenn die Farbkarte hineingeht, das ist besonders offensichtlich.
Ich habe eine Liste der Szenen erstellt. Jedes Bild wird nur mit dem Namen des Bildes, dem chinesischen Titel, dem chinesischen Text, dem englischen Sprachübertragung und der Position des Bildes nach oben und unten aufgezeichnet:
Json
{
  "image": "03-i-walk.png",
  "title": "后来,他说我自己走",
  "chinese": "那天过马路,他第一次说:「我自己走。」",
  "english": "Then one day, at the crosswalk, he said it for the first time. I can walk by myself.",
  "imagePosition": "center 64%"
}
Letztendlich lässt sich dieser Standortparameter vernachlässigen. Jedes Bild steht in einer anderen Position, alles mechanisch in der Mitte, entweder den Kopf, oder die Hände.
Wie man die englische Stimme und Untertitel verbindet?
Mit Samantha 's Voice in macOS werden 165 englische Wörter pro Minute gesprochen, wobei jeder Satz einzeln generiert wird. Dieser Prozess wird als Text-to - Speech bezeichnet und wird oft als TTS abgekürzt.
Wenn die Maschine hoch ausgestattet ist, verwenden Cosyvoice Kleine Modelle synthetisieren die Stimme besser.
Bash
say -v Samantha -r 165 -o scene.aiff "English narration here"
ffmpeg -i scene.aiff -ar 48000 -ac 1 scene.wav
Lassen Sie sich nicht sechs Seiten in einem großen Dokument lesen. Wenn es ein Problem mit der Aussprache des dritten Satzes gibt, muss man nur den dritten Satz ändern, die ersten beiden Satze müssen nicht wiederholt werden.
Nachdem die Sprache erzeugt wurde, liest man die tatsächliche Länge jedes Absatzes. Nehmen Sie den höheren Wert von „Mindestens 6,4 Sekunden" und „Narrationsdauer plus 0,55 Sekunden" für jeden Satz. Die kurzen bleiben mindestens 6,4 Sekunden, die langen warten, bis sie eine halbe Sekunde mehr lesen. Raten Sie nicht, wie viele Buchstaben es auf Englisch gibt, nicht lange.
Die englischen Untertitel haben keine zusätzlichen Wort-Zeitcode. Ich benutze "die gespielte Zeit ÷ die Gesamtdauer dieser Sprache", um zu berechnen, wie viele Wörter ich jetzt enthüllen soll. Jeder Absatz hat nur 18 - 20 Wörter und reicht aus, um diese Art von Untertiteln zu machen. Wenn Sie ernsthaft Englisch unterrichten möchten, verlangen Sie, dass die Stimme genau auf welches Wort verweist, dann sollten Sie jedes Wort mit einem Zeitzeichen versehen.
Chinesisch nur angezeigt, nicht vorlesen. Die Zeit von 39,6 Sekunden wird schnell auf eine Minute verlängert und das Publikum wird sehr langweilig warten.
Bild und Stimme erzeugen eine Version, Hintergrundmusik zuletzt gemischt. Die Lautstärke der Musik wird zuerst auf 0,08 gesetzt, wenn die Stimme auftritt, wird die Musik automatisch reduziert und schließlich die maximale Lautstärke begrenzt, um plötzliche Klangschläge zu vermeiden. Die ursprünglichen spezifischen Parameter sind Threshold 0,02, Ratio 9, Attack 18ms, Release 300ms und der Spitzenwert darf nicht über 0,95 liegen. Sie passen nur zu diesem Film und dieser Musik, ein Song muss man wieder hören, nicht als uralte Rezept.
Es gibt auch einen Ort, an dem man sich leicht gut fühlt: Whisper kann vollständig diktiert werden, was nur darauf hindeutet, dass die Maschine verstanden hat und nicht die natürliche Stimme repräsentiert. Samantha diese Version, um die Methode zu überprüfen, ist kein Problem, bevor es wirklich noch mit dem Handy vollständig zu hören. Müde, nicht wie die Zeitung, die Ohren sagen.
Zusammenfassung
Erstens, die Person bezieht sich auf die Provinz. Wenn man hundert Mal „die gleiche Mutter" in einem Tipp schreibt, ist es in der Regel besser, dasselbe Referenzbild jedes Mal mitzunehmen.
Zweitens: Eine Karte. Nehmen Sie nicht ein Bild und sagen Sie gleichzeitig "Kind weigert sich zu umarmen" und "Mama umarmt ihn abends", das Publikum wird nicht wissen, was sie sehen sollen.
Drittens ist die Graustufenkarte kein echtes Text. Der ursprüngliche Hintergrund ist zu kompliziert und ist nach dem Entfernen der Farbe immer noch schmutzig. Ein bisschen sauberes Originalbild zu wechseln, ist nützlich als verrückt Kontrast ziehen.
Viertens: Lassen Sie das Video-Modell nicht das ganze Stück wiederholen. Diese Form erfordert die Stabilität der Figuren, der Komposition und des Textes, und es gibt keine Inhalte, die sich auf kontinuierliche Bewegungen verlassen müssen, um klar zu sagen. Das Video-Modell ersetzt Gesicht, Hände oder Kleidung, um viel mehr zu verarbeiten.
Zum fünften, die Hintergrundmusik. Bilder und Sprachübertragungen sind nicht vor der Musik zu beeilen, sonst wissen Sie nicht, ob die Geschichte langsam ist, die Stimme langsam, oder die Musik in der Stimme.
Sechstes, nur endgültige MP4 akzeptiert. Ich übergab das Video wieder an die lokale Spracherkennung, die alle sechs englischen Sätze aufgerichtet waren; ich überprüfte die Leinwand, die Framerate, die Codierung und die Audiospuren automatisch. Die Vorschau im Editor ist normal und bedeutet nicht, dass die exportierten Dateien normal sind.
Diesmal möchte ich es nicht in eine neue Fließlinie verwandeln. Ich nehme diesen Film nur eine Sache zu überprüfen: Ich habe bereits eine Reihe von stabilen, sauberen Geschichten Illustrationen von Charakteren in der Hand, die ein anderes Layout und eine Zeitleiste haben, um diesen zweisprachigen Handgemälde-Effekt zu erstellen.
Ich werde zuerst eine natürlichere englische Stimme (CosyVoice) wechseln, senden, um die Daten zu sehen und dann entscheiden, ob es sich lohnt, mehr zu tun.