
このビデオを見たとき、私の最初の反応は、このビデオを再現できるということでした。ストーリーは重要ではありません。今私たちを選んで、主に効果を見てください。写真があり、物語があり、音声も合成できます。私の気持ちはすべての準備ができている、最初に1つを作ることです。
ストーリーマップはどうですか?
物語はとても簡単です:子供は常に手を開いて保持し、母親は彼の重い笑いを保持します。ある日、子供が初めて“自分で歩く”と言いました。母の手は空中で止まり、最後に抱きしめたのがいつだったのか思い出せなくなった。その夜、彼女は再び眠っている子供を拾った。
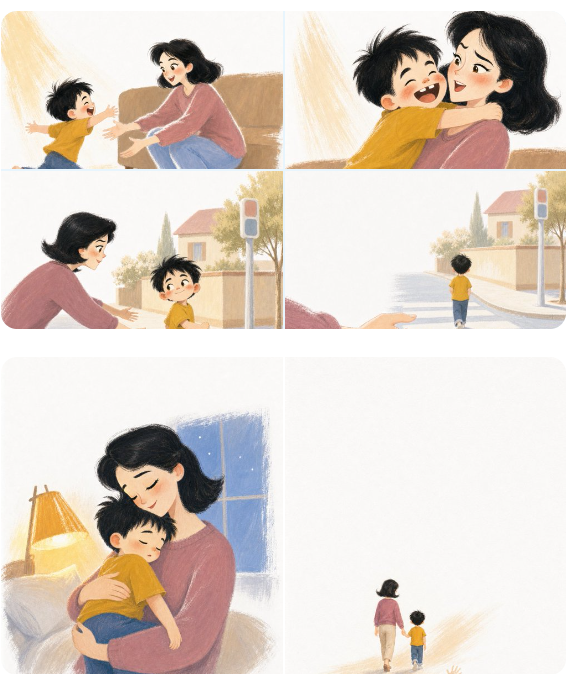
6つの画像に分割しました。
-
子供は手を開いて母親に駆け寄った。
-
母は彼を抱きしめ、口に“重すぎる”と言いました。
-
道を渡るとき、子供は初めて“自分で歩く”と言いました。
-
母親の手は空中にぶら下がっており、子供の背中はますます遠くなっている。
-
夜、母は眠っている子供を抱き上げた。
-
“最後の時間は事前に通知されない”というフレーズを保持するために、大きくて小さい2つの背中が遠くにあります。
6枚の写真が便利です。最初の2つは“彼はいつも抱きしめていた”と信じさせ、3つ目は日常生活を中断し、4つ目は母親に反応させ、5つ目は母親の動きを与え、最後の1つは最後のものになる。真ん中の1つが欠けていると、感情はハードになります。
その後、固定人物。私たちは最初に母親の参照図と子供の参照図を準備しました:母親は黒い肩の上の短い髪、サンドピンクの紫色のセーターです。子供は5歳、黒い髪、丸い顔、前歯の欠如、マスタード黄色のTシャツを着ています。6枚の写真は、この2枚の人物参照図を一緒に画像生成ツールに渡し、服は完全に変更されません。
言葉だけでシナリオを推測しないでください。リビングルーム、ストリート、夜間の寝室は、環境参照図を準備してください。リビングルームの画面を作るときはリビングルームのリファレンスを取り、シマウマの横断歩道を作るときはストリートのリファレンスを取ります。背景は同じではありませんが、同じ家、同じ通りが突然異なる画像で装飾を変更しないでください。
画像はCodexに内蔵された画像生成機能を使用しており、1つのフィールドに1枚、3:4縦グラフを作成し、画像なしで文字を生成します。共通提示语は大体次のようになる:
同一位妈妈:黑色齐肩外翘短发,鹅蛋脸尖下巴,细长脖子,
豆沙粉紫圆领毛衣。

同一个五岁男孩:头大身小,黑色乱发,圆脸短脖,
缺一颗门牙,芥末黄 T 恤。全程不换衣服。

画风:1950 年代美式中古动画概念稿,传统水粉和彩铅,
画在白纸上,大面积留白,环境像舞台布景,不像照片。

构图:3:4 竖版,顶部至少 35% 留白,四个角保持白色,
不要日系动漫脸、3D、矢量插画、满构图、文字、水印、
额外人物和服装变化。
そして、各マップは本当に必要なアクションと環境だけを補完します。例えば、4番目:
同一街口。妈妈豆沙粉紫袖口和悬空的手占前景,
手指微微收拢;远处是儿子穿芥末黄 T 恤走远的小背影。
画面保留大片空白,色调比上一幕稍冷,情绪克制。
より多くの文学を書く必要はありませんが、変更されるものを固定します:同じ人、同じ服、同じスタイル、同じ空白の種類。1つのシーンは1枚の画像だけを作成し、2つのプロットの上に1枚の画像を取らないでください。
最低6枚の写真を撮る必要があります。実際に何回生成されるかは、キャラクターが顔を変えているか、手が悪いか、構図がテキストの位置を確保できるかによって異なります。当時の制作ファイルには、最終的に使用された6枚の画像しか残っておらず、再試行や手数料の控除も完全に保存されていなかったので、“総費用はいくらですか?”を編集しません。
6枚の画像が完成した後、オリジナルの短編映画のアプローチも非常に簡単です。各画像は4.25 秒で、最初に白い紙に中国語を文字で印刷し、同じ画像のグレースケール版を左から右に表示させ、最後にカラー画像を左から右に表示させます。キャラクターを動かさずにシーンを切り替えます。6枚の画像を合わせると25.5 秒で、バックグラウンドミュージックとタイピング音があり、ナレーションはありません。
これでオリジナルの短編映画は完成しました。
ビデオの除外法
最初のビデオ分析:各レイアウトは基本的に同じです:上の文、真ん中の図、英語と英語の下の英語;音声は英語のみを読みます。画像は空白からグレースケールに変わり、左から右にカラーになります。
ビデオモデルを使わずに現場で生成されたように見えます。同じ画像は2つのレイヤーをコピーし、下のレイヤーは色を取り除き、上のレイヤーはカラー画像を保持し、2つのレイヤーは左から右にマスクを行います。つまり、徐々に可視領域を解放します。私が使用するツールも説明します:
-
ChromeブラウザはXのオリジナル投稿やリファレンスビデオを表示します。
-
macOSのSayは英語のテキストを音声に変換します
-
RemotionはWebコード(React)で動画を組版して生成するツールで、画像、テキスト、マスク、タイムラインを担当します。
-
FF mpegは、ビデオとオーディオを処理するためのコマンドラインツールで、オーディオフォーマット変換とバックグラウンドミュージックの最終ミックスを担当します。解像度、フレームレート、長さ、オーディオトラックをチェックするためのffprobeが付属しています。
-
MLX Whisperはローカル音声認識モデルである。完成したら、英語を口述して、単語の漏れや切り捨てがないかどうかを確認します。
スクリプトの実行環境はNode.js 22.2 2.1で、動画はRemotion 4.0.4 8 4とFF mpeg 8.1.2を使用しています。ツールの名前は、実際には、画像はRemotionに、音はFF mpegに、他のツールは主にチェックを担当します。
各アニメーションパラメータは最終的に設定されました。最初に0.2 秒空、グレースケールは1.45 秒でスキャンし、カラーは1.2 秒でスキャンします。マスクのエッジは10%柔らかくなり、画像は1 倍から1.0 22倍にゆっくりと拡大します。幅は小さいですが、動かないと、6秒は確かにPPTのように見えます。
TypeScriptの略。
const sketchProgress = interpolate(t, [0.2, 1.65], [0, 1]);
const colorProgress = interpolate(t, [1.65, 2.85], [0, 1]);

show(grayscale(image), leftToRightMask(sketchProgress));
show(image, leftToRightMask(colorProgress));
グレーレイヤーとカラーレイヤーは、同じ画像、同じトリミング位置、同じズーム値を使用する必要があります。下に“より線画のような図”を作成しないでください。2つの画像は、五感が少し離れている限り、カラー画像が入ってくると顔がジャンプします。
別のシーンのリストを作りました。各セッションは、画像名、中国語タイトル、中国語本文、英語のブロードキャスト、画像の上下のオフセット位置のみを記録します。
ジェイソン·ジョンソン
{
  "image": "03-i-walk.png",
  "title": "后来,他说我自己走",
  "chinese": "那天过马路,他第一次说:「我自己走。」",
  "english": "Then one day, at the crosswalk, he said it for the first time. I can walk by myself.",
  "imagePosition": "center 64%"
}
最後に、この位置パラメータは別です。各キャラクターの位置は異なり、すべて機械的に中央に配置され、ターンを切るか、手を切る。
英語の音声と字幕のつながり
macOSのサマンサの声を使用して、1分間に165英語の単語の速度で、それぞれが別々の段落を生成します。このプロセスはテキスト音声変換と呼ばれ、しばしばTTSと略されます。
マシンが高い場合は、 CosyVoiceの 小さなモデルの合成音声の方が効果的です
BASHの略。
say -v Samantha -r 165 -o scene.aiff "English narration here"
ffmpeg -i scene.aiff -ar 48000 -ac 1 scene.wav
1つの大きな文書に一度に6つの記事を読まないでください。第3場の発音に問題がある場合は、第3場のみを変更し、最初の2場をやり直す必要はありません。
音声が生成されると、各セグメントの実際の長さが読み取られます。“少なくとも6.4 秒”と“ナレーション時間に0.55 秒を追加する”のいずれか大きい値を取ります。短いものは少なくとも6.4 秒停止し、長いものは残りの半秒を読み終えた。英語の文字の数で時間を推測しないでください。
英語字幕には別の単語タイムコードはありません。“再生された時間÷この音声の合計時間”を使って、表示される単語の数を計算します。各パラグラフは18-20語であり、このような物語の字幕には十分です。適切な英語教育を行いたい場合は、音がどの単語を正確に指しているかを要求する場合は、各単語にタイムスタンプを付ける必要があります。
中国語は表示のみで、読み上げはしません。英語と英語を読むと、39.6 秒がすぐに1分になり、視聴者は退屈になります。
映像と人間の声が一つになり、バックグラウンドミュージックが最後にミックスされます。音楽の音量を0.0 8に設定し、ボーカルが現れると自動的に音楽を下げ、最後に最大音量のピークを制限して突然の爆発を避ける。元のパラメータは、しきい値0.0 2、比率9、アタック18ms、リリース300msで、ピーク値0.95以下です。彼らはこの映画とこの音楽にしか合いません新しい曲は先祖代々のレシピではありません
また、自分が良いと感じやすい場所があります。Whisperは完全に口述でき、機械が理解していることを示すだけで、自然な音ではありません。Samantha 这版拿来検证方法没问题,真发以前还是要用电话外放完全听一遍。疲れていない、ニュースステーションのように、人々の耳が支配する。
まとめまとめまとめ
第一に、人物は図别省を参照する。ヒントに“同じお母さん”と100回書いて、いつも同じ人物の参照図を持っていく方がいいでしょう。
第二に、1つのチャート。“子供は抱きしめることを拒否した”と“お母さんは夜に抱きしめる”と同時に言ってはいけません。観客はどちらを見るべきかわかりません。
第三に、グレースケールは真のラインではない。背景は複雑すぎて、色を取り除いても汚れています。コントラストをクレイジーに引っ張るよりも、少しきれいなオリジナル画像に切り替えることができます。
第四に、ビデオモデルにスライス全体を一度にやり直すようにしないでください。この形式は、文字、構成、テキストの安定性を必要とし、連続した動きに頼らなければならない内容を明確に伝えることはできない。ビデオモデルは、顔、手、衣服を1つ変更し、より多くの作業を行います。
第五に、バックグラウンドミュージックです。映像と口放送が決定されない前に音楽を急いではいけません。そうでなければ、物語が遅い、音が遅い、音楽が声を奪っているのかわかりません。
最後に、最終的なMP 4のみを認識する。私はフィルムをローカルの音声認識に渡し、6つの英語をすべて一致させ、キャンバス、フレームレート、エンコード、オーディオトラックを自動的にチェックしました。エディタのプレビューは正常ですが、エクスポートされたファイルは正常ではありません。
今回は新しいラインにはしません。私は1つのことを確認するためにこのフィルムを取ります:安定したキャラクター、きれいな構図のストーリーイラストのセットがあり、レイアウトとタイムラインを変更すると、このバイリンガルの手描き効果を作成できます。
後で本当に続けなければならないので、もっと自然な英語の声(CosyVoice)に変えて、データを送って、値がもっとやる価値がないかどうかを判断します。